Yapay zekâ kararı: kelime mi, olasılık puanı mı?
Aynı iade kararı 540 kez soruldu. Metin ve olasılık puanı döndüren modelleri karşılaştırdım; puanlar yanlış etiketlenmiş bir vakayı görünür kıldı.
Bir iade sisteminin otomatik karar vermesi için yalnızca “iade et” demesi mi gerekir, yoksa bu kararın ne kadar güçlü olduğunu gösteren bir puan mı? Bu deneyde iki yaklaşımı aynı müşteri talepleriyle karşılaştırdım. Son benchmark'ımdaki (yöntemleri aynı koşullarda karşılaştıran ölçüm) iade agent'ı (araç kullanarak bir görevin adımlarını yürüten yapay zekâ ajanı) önemli tek bir karar veriyor: müşteriye parayı otomatik iade et ya da vakayı bir insana devret. O benchmark'ta bu kararı senaryolu bir model veriyordu; tek değişken runtime (kodun çalıştığı ortam) olsun diye. O adıma gerçek bir model koymadan önce, karar bir kelime yerine bir sayı olarak dönerse neyin değiştiğini bilmek istedim.
Bu yüzden aynı kararı üç yoldan, 540 kez sordum ve her cevabı sakladım. Lab sayfası kaydedilmiş çalıştırmau yeniden oynatıyor ve eşiği kendiniz kaydırmanıza izin veriyor. Kod ve iki çalıştırma GitHub'da.
Kurulum
Bu, agent-runtime-bench'teki agent'ın karar adımı. O benchmark modeli sabit tutup runtime'ı değiştiriyordu. Bu benchmark, modelin cevap verme şekli dışında her şeyi sabit tutuyor.
Politikanın dört kuralı var: sipariş var, teslimden en fazla 30 gün geçmiş, ürün kullanılmamış ya da hasarlı gelmiş ve iadesiz satış değil. Eksik ya da çelişkili her şey insana gider.
60 destek talebi: 48'i aynı başlangıç değeriyle tekrarlanabilen örnek üretme şablonlarından, 12'si elle yazılmış, çünkü şablonlar canı yakan vakaları hiç üretmiyor. 30. gün ile 31. gün. Kırık gelmiş iadesiz bir ürün. Var olmayan bir sipariş. Kayıtta 41 gün önce teslim görünürken "dün geldi" diyen bir destek talebi. Büyük harflerle yazılmış bir prompt injection (okunan içeriğe gizlenen talimatlarla yapay zekâyı yönlendirme girişimi). 23 destek talebinde iade yapılmalı, 37'si insana gitmeli.
Her kol aynı üç şeyi alıyor: politika, sipariş kaydı ve müşteri mesajı. Her destek talebi üç yöntemin her biriyle üç kez değerlendiriliyor.
- Sohbet JSON (veriyi alan ve değer çiftleriyle taşıyan metin biçimi). Claude Haiku 5.5,
{"decision": "refund"}ya da{"decision": "handoff"}dönmesi isteniyor. - Katı şema (verinin hangi alanları ve türleri içereceğini belirleyen yapı). Aynı çağrı, tek izinli değerleri bu iki etiket olan bir JSON şemasıyla.
- Karar. OpenRouter Decisions API (yazılımların birbirine istek göndermesini sağlayan arayüz) üzerinden Jev 1.13: tek bir evet/hayır sorusu; cevap, müşterinin iadeye uygun olma olasılığı.
Karar çağrısı kısa ve ayrıştırılacak bir şey yok:
const response = await fetch('https://openrouter.ai/api/alpha/decisions', {
  method: 'POST',
  headers: { Authorization: `Bearer ${apiKey}`, 'Content-Type': 'application/json' },
  body: JSON.stringify({
    model: 'typesafe/jev-1.13',
    state: { policy, order_record: ticket.order, customer_message: ticket.message },
    questions: { qualifies: { type: 'noul', instructions: QUESTION } },
  }),
});
const probability = (await response.json()).answers.qualifies.noul;
Doğrulukta beraberlik
| kol | 180'de doğru | gereksiz devir | p50 | 1000 karar |
|---|---|---|---|---|
| sohbet JSON | 175 | 5 | 2064 ms | $0.132 |
| katı şema | 177 | 3 | 2138 ms | $0.134 |
| karar, 0.5 | 177 | 3 | 506 ms | $0.020 |
Hiçbir kol politikanın yasakladığı bir iadeyi ödemedi. Düz JSON 175 kez doğru bildi ve bir destek talebine çalıştırmalar arasında iki farklı cevap verdi. Şemayla sohbet modeli 177 yaptı; karar modeliyle tamamen aynı skor ve aynı tek hata. Karar modeli bu çalıştırmada karar başına yaklaşık dört kat hızlı ve altı kat ucuzdu, çünkü bir sayı dönüyor ve açıklama metni üretmiyor.
Hikâye sadece doğruluktan ibaret olsaydı, şema konuyu kapatırdı.
Sayı başka bir şey yaptı
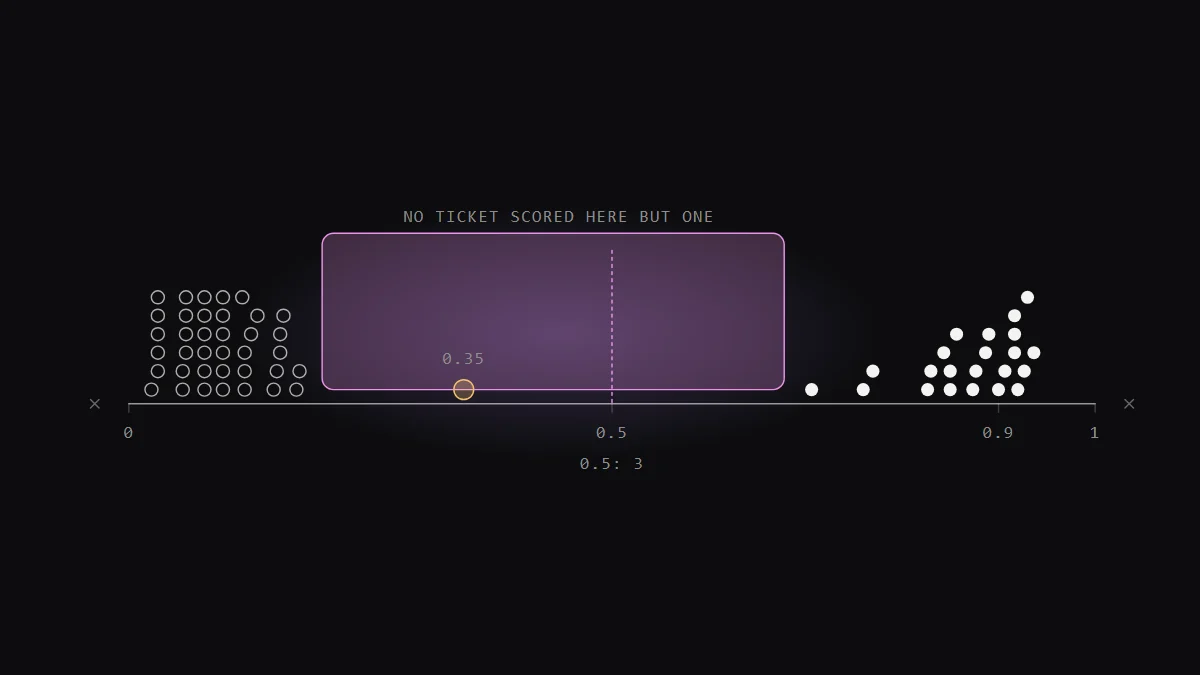
İnsana gitmesi gereken her destek talebi 0.18 ya da altında kaldı. İade edilmesi gereken her destek talebi 0.69 ya da üstünde. Aralarında boş bir bant var ve içinde tek bir destek talebi duruyor.
O destek talebi x05: "Odamda bir kere denedim, bu kullanılmış sayılır mı? Etiketler üstünde." Çalıştırmadan önce onu iade diye etiketlemiştim. Her kol onu insana gönderdi. Sohbet modeli orada, prompt injection'a handoff dediği şekilde aynen handoff dedi. Karar modeli x05'e 0.35, injection'a 0.03 verdi.
Aynı kelime olan iki cevap aynı karar değil. Biri "hayır, belli ki" diyor, diğeri "bundan anlayamıyorum". Üç koldan sadece biri bu farkı gösterebildi ve gösterdiği yer, veri setimde bugün değiştireceğim tek etiketti.
Eşiğin yeri boşluğun içi
0.9 güvenli seçim gibi hissettiriyor. Bu skorlarla 180 çağrının 41'ini boşuna insana gönderiyor ve fazladan tek bir yanlış iadeyi bile durdurmuyor, çünkü 0.5'te durdurulacak yanlış iade zaten yoktu.
| eşik | doğru | yanlış iade | gereksiz devir |
|---|---|---|---|
| 0.5 | 177 | 0 | 3 |
| 0.7 | 176 | 0 | 4 |
| 0.8 | 168 | 0 | 12 |
| 0.9 | 139 | 0 | 41 |
| 0.95 | 111 | 0 | 69 |
Güvenli sayı modelin değil, verinizin bir özelliği. Artık onu şöyle seçiyorum:
- Gerçek vakalardan bir örneği, politikanın ne dediğine göre etiketleyin.
- Skorlayın ve o örnekte sıfır yanlış iade veren en düşük eşiği alın. Burada 0.19, boşluğun kenarı.
- Pay bırakın, mevcut sürecin yanında gölgede çalıştırın (kararlarını gerçek işlemlere uygulamadan mevcut sistemle karşılaştırın) ve ayrıştıkları her vakayı okuyun.
function lowestSafeThreshold(labelled: { p: number; shouldRefund: boolean }[]): number {
  for (let step = 5; step <= 99; step++) {
    const threshold = step / 100;
    const wrongRefunds = labelled.filter((item) => item.p >= threshold && !item.shouldRefund).length;
    if (wrongRefunds === 0) return threshold;
  }
  return 1;
}
Bu döngünün ilk hali float'a (ondalıklı sayıları temsil eden veri türü) 0.01 ekliyordu ve 0.18 döndürüyordu; bu da 0.18 skorlu devir destek talebini içeri alıyor. Tam sayıyla sayın.
Skorlar tekrar ediyor
42 dakika sonraki ikinci tam çalıştırmada hiçbir destek talebinin ortalama skoru 0.033'ten fazla oynamadı. x05 0.35'ten 0.34'e indi, devir grubu yine 0.18'de bitti, iade grubu yine 0.70'te başladı. Pazartesi seçilen bir eşik salı da aynı anlama gelmeli; burada geldi. Repoda bunun için bir test var.
Yaparken ne yanlış gitti
Üç şey, üçü de benim hatam.
Sohbet modeli 163 kez boş, 2 kez yarım döndü. Çıktıyı 50 token'la (modelin metni işlerken saydığı küçük parça; her zaman bir kelime değildir) sınırlamıştım. Haiku 5.5 cevap vermeden önce düşünüyor; düşünme bütçeyi bitirdi ve JSON'a yer kalmadı. İlk tablo sohbet modelinin bozuk olduğunu söylüyordu. Bozuk olan benim limitimdi. Kaydedilen çalıştırma 1024'e izin veriyor.
Şablonlarım saçma cümleler yazdı. Bir kombinasyon "açılmayan koşu ayakkabısı" üretti. Sohbet modeli o destek talebini üç seferde üç kez insana gönderdi; bir çelişki karşısında yapılacak makul şey buydu. Cümleleri üründen bağımsız yaptım ve yeniden koştum.
Bir etiket tartışmalıydı. x05 sınırlar bölümünde, üstünde benim adımla duruyor. Kendi anlaşmazlıklarını saklayan bir benchmark pek bir şey ifade etmez.
Hangisini ne zaman
- Cevap bir insana göstereceğiniz bir kelimeyse ya da sonraki adım akıl yürütme istiyorsa: sohbet modeli.
- Cevap sabit bir kümeden biriyse ve ona göre dallanacaksanız: katı şema ekleyin. Formatı bedavaya düzeltir.
- Modelin ne kadar emin olduğuna göre yönlendirmek, belirsiz ortayı bir insana göndermek ya da yüksek hacimde karar başına ödemek istiyorsanız: olasılık isteyin ve eşiği etiketli veriden seçin.
O agent'ın karar adımına gerçek bir model geldiğinde, ondan sayı istenecek.
Sınırlar
60 sentetik destek talebi ve tek politika. Tek sohbet modeli. Gecikme İstanbul'daki tek bir noktadan, OpenRouter üzerinden, eşzamanlılık 6 ile. Maliyetler, OpenRouter'ın her çağrı için döndürdüğü usage.cost. Bu, Jev'i genel olarak test etmiyor: decision-model-benchmark ve DecideBench çok daha fazla görevi kapsıyor. Bu yazı tek bir şeyi test ediyor: bir skorun, bir eşikle ne yapmanıza izin verdiği.
Bu yazı İngilizce aslından Türkçeye çevrilmiştir.
Bu yazıya bırakılan notlar
Katıl
Yükleniyor…
Bir yorum bırak.
Bu yazıya not eklemek için giriş yap.
Sadece adın ve avatarın kullanılır.