Sıfırdan yönetim paneli ve belgeye dayalı yapay zekâ asistanı
Revotas’ta müşteri, destek ve fatura işlemlerini birleştiren paneli ve Türkçe belgelerden kaynak göstererek yanıt veren asistanı nasıl geliştirdim?
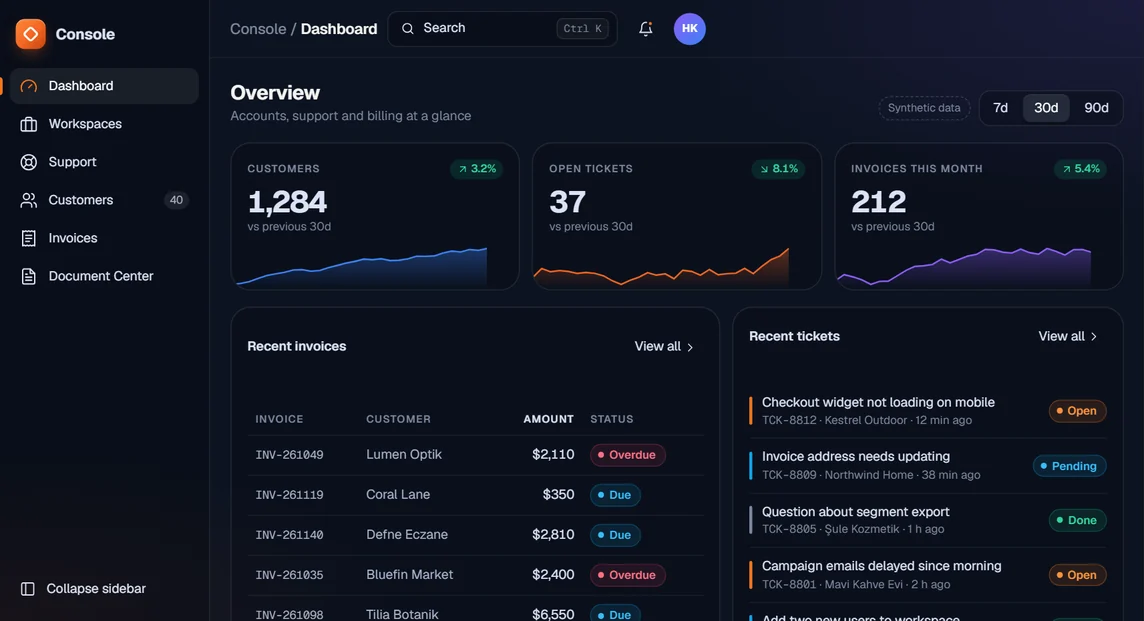
Bir ürünün kalitesini, müşterinin gördüğü her şeyden önce admin panelinden okursunuz. Revotas'taki eski panel sunucuda render (veriyi ekranda gösterilecek görünüme dönüştürme) edilen sayfalardan oluşuyordu ve satış, destek ve fatura ekipleri işlerini orada yürütüyordu.
Nisan 2026'da yenisine başladım. Projedeki tek mühendis bendim. 17 Nisan ile 1 Ekim arasında iki repo (projenin dosyalarını ve değişiklik geçmişini tutan kod deposu) üzerinde 78 commit (kod deposuna kaydedilen değişiklik paketi), yaklaşık 28 bin satır TypeScript ve TSX, 30 civarında ekran çıktı.
Sonunda iki yarı ortaya çıktı. Biri operasyon konsolu: CRM (müşteri ve ilişki kayıtlarını yöneten sistem), destek talepleri, faturalama ve sizi doğrudan bir müşterinin workspace'ine (bir müşteriye veya ekibe ayrılmış çalışma alanı) götüren bir köprü. Diğeri Doküman Merkezi: Türkçe ürün dokümanlarımızdan cevap veren ve her cevabın nereden geldiğini gösteren bir RAG (yanıt üretmeden önce ilgili belgeleri bulup modele sunma yöntemi) asistanı.
İşi zorlaştıran ne oldu
Backend (uygulamanın sunucuda çalışan bölümü) zaten vardı ve onu yeniden yazmıyordum. Her ekran, yıllar önce başka bir arayüz için yazılmış, kendi session kuralları ve yanıt yapıları olan endpoint'lerin (bir serviste istek gönderilen belirli adres) üstüne oturmak zorundaydı.
Veri gerçek müşteri verisiydi, yani yaptığımı şirket dışında kimseye gösteremezdim. Panel de saatlerce açık kalıyor; yavaş bir sızıntı ya da render döngüsü öğleye kadar kendini belli ediyor.
Stack (bir üründe birlikte kullanılan teknolojiler): React 19, TypeScript, Vite 6, Tailwind 4, Radix primitive'leri ve yoğun listeler için TanStack Table.
Karar 1: yeni ekranı yazmadan önce eski sözleşmeyi oku
İlk notlarım sorulardan oluşuyordu. Kullanıcı panele nereden giriyor? İlk karar ekranı hangisi? Hangi eski akış hangi yeni sayfaya karşılık geliyor?
Cevaplar eski sistemin davranışındaydı ve o davranış biraz yanıltıcıydı. Bir endpoint'in adı login kullanıcılarını yönettiğini düşündürüyordu. Aslında contacts tablosuna yazıyordu. Aylar sonra kafa karıştıran bir hata bildiriminin kaynağı tam olarak bu isim çıktı.
Başka bir endpoint müşteri adlarını Latin1 olarak okunmuş UTF-8 byte'ları (bilgisayarda sekiz bitlik veri birimi) şeklinde döndürüyordu; Türkçe harfler bozuk geliyordu. Farklı bir endpoint aynı satırları düzgün veriyordu. Güvenlik ağı olarak küçük bir onarım fonksiyonu yazdım ve mümkün olan her yerde temiz endpoint'i kaynak olarak tuttum.
Liste performansında da durum aynıydı. Müşteri listesine bir "son yorum" kolonu eklemek, müşteri başına bir istek, yani yaklaşık 1.460 istek demekti. Backend ekibinden liste yanıtına tek bir toplu alan eklemelerini istedim ve onu tek bir mapper'da bağladım. Listeler 60 saniyelik bir cache'in (yeniden kullanmak için saklanan geçici veri, yani önbellek) arkasında; aynı listeyi isteyen iki bileşen devam eden tek bir isteği paylaşıyor.
Aramanın Türkçe harfleri arama için doğru normalleştirmesi gerekiyordu. "İ" ve "ı" Türkçede İngilizceden farklı küçülüyor, o yüzden sıralama ve eşleştirme her yerde tr locale'i kullanıyor.
Karar 2: Cmd+K ve hareket ayarı ilk haftada
Bu ikisi cila gibi görünür. Ben ilk onları yaptım.
Klavyeyle çalışan bir kullanıcı paneli klavyeden yönetmek ister; global gezinmeyi bir komut paleti (Cmd+K) üstleniyor. Harekete duyarlı bir kullanıcı animasyonu kısmak ister; Panel Ayarları'nda Animation Intensity seçeneği var: Reduced ya da Full Motion.
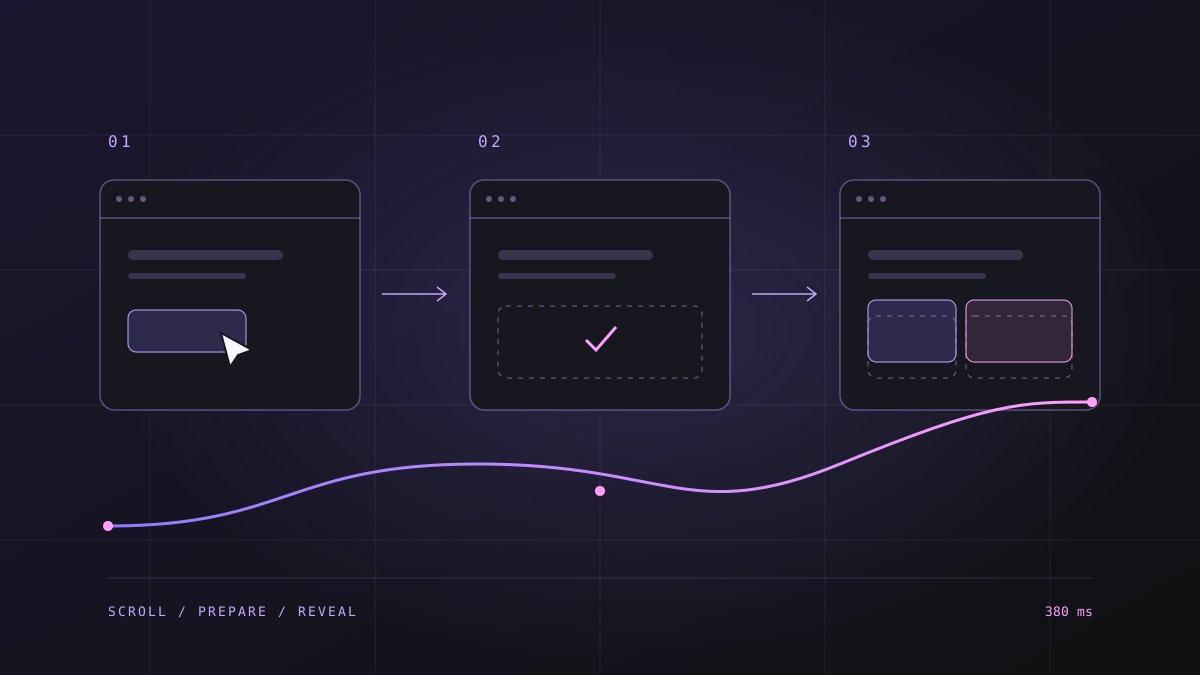
Bu kararı erkenden almak gerçek kodu değiştirdi. Login ekranında günün saatine göre beş farklı atmosferi olan bir canvas arka planı var; işletim sistemi azaltılmış hareket istediğinde ya da sekme gizlendiğinde kendini yavaşlatıyor. Animasyonlu bileşenler ilk günden hareket ayarını bir girdi olarak almak zorundaydı. Bunu sonradan eklemek her ekrana dokunmak demekti.
Karar 3: taşımanın sebep olmadığını kanıtla
Yaklaşık 1.450 eski müşteri kaydını tek seferde yeni CRM'e taşıdık. Birkaç hafta sonra bir şikayet geldi: farklı markaların kullanıcıları yanlış tenant (aynı sistemde verileri ayrı tutulan müşteri alanı) altında görünüyordu ve ilk şüpheli taşımaydı.
Ben de salt okunur SQL çalıştırdım. Taşıma dört CRM tablosuna yazmıştı, başka hiçbir yere değil. O tablolarda panel login'i oluşturan bir trigger yoktu. Kullanıcı tablosundaki yanlış tenant deseni de taşıma tarihinden yıllar öncesine gidiyordu.
Düzeltme başka bir ekibin tarafında yapıldı ve sonrasında gelen yeni kullanıcıların hepsi doğru yere düştü. Bu hikayeyi seviyorum, çünkü cevap herkesin tekrar çalıştırabileceği bir sorguydu.
Karar 4: demoya uygun ayrı bir dal
İşi tek bir müşteri satırını sızdırmadan dışarıda paylaşmak istedim. Bunun için ayrı bir branch (ana koddan ayrı ilerletilen geliştirme dalı) açtım: mock veri katmanı, temizlenmiş isimler ve feature flag'lerin (özelliği kodu değiştirmeden açıp kapatan ayar) arkasına alınmış hassas akışlar.
Bu da başlı başına küçük bir mühendislik işine dönüştü. Her ekranın hiçbir ağ isteği yapmadan inandırıcı veri göstermesi gerekiyordu. Yukarıdaki kayıt o branch.
Karar 5: "bilmiyorum" diyebilen bir RAG asistanı
Doküman Merkezi basit bir soruya cevap arıyor: biri Türkçe ürün dokümanlarımızı okumadan oradan cevap alabilir mi?
Ingest (belgeleri okuyup sistemin kullanacağı biçime hazırlama) tarafı PDF, DOCX, Markdown ve düz metin okuyor; dosya başına sınır 25 MB. Chunker (uzun belgeyi daha küçük bölümlere ayıran araç) önce paragraflara bölüyor, paragraf çok uzunsa cümlelere, son çare olarak kelimelere. Chunk'lar (uzun bir belgeden ayrılan küçük metin bölümü) 800 token (modelin metni işlerken saydığı küçük parça; her zaman bir kelime değildir) hedefliyor ve 150 token örtüşüyor.
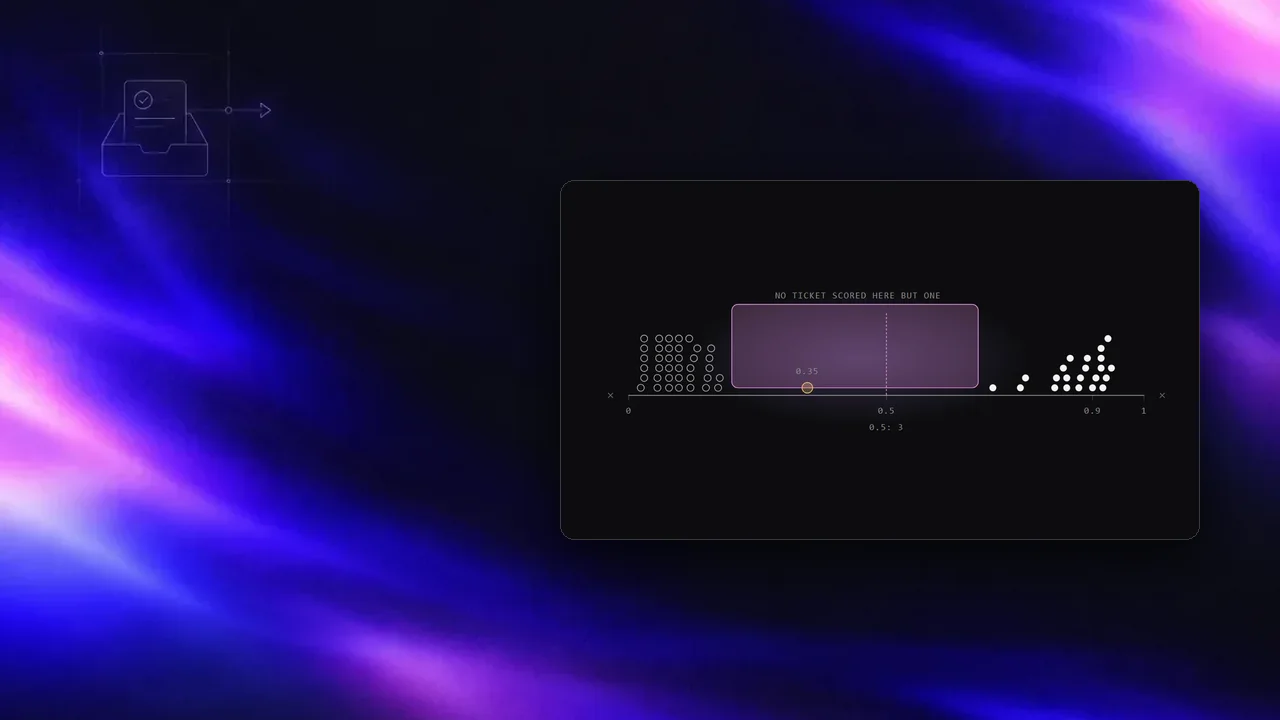
Her chunk için bir embedding (metni benzerlik hesabında kullanılabilen sayı dizisine dönüştürme) üretiliyor. Soru da embed ediliyor ve cosine (iki vektörün yön benzerliğini ölçen kosinüs hesabı) benzerliği en iyi 5 chunk'ı seçiyor. En iyi eşleşmenin skoru 0,6'nın altındaysa cevap dokümana dayanmıyor ve asistan bunu açıkça söylüyor.
"Sadece dokümanlar" modunda doğrudan reddediyor ve ilgili bir doküman yüklemeyi öneriyor. Küçük sohbet ("merhaba", "teşekkürler") bu kontrolü atlıyor; bir selama ret cevabı dönmüyor.
Grounded prompt (yapay zekâya verilen talimat veya soru) Türkçe yazıldı. Modele yalnızca verilen bölümlerden cevap vermesini ve bölümler soruyu karşılamıyorsa bunu açıkça söylemesini söylüyor. Kaynaklar ilk token akmadan önce istemciye ayrı bir event (bir işlemin gerçekleştiğini bildiren olay) olarak gidiyor; arayüz dosya adı ve kısa bir alıntıyla kaynak çipleri gösterebiliyor. Sunucu durum aşamalarını da gönderiyor (tarama, okuma, üretim), yani arayüz cevap başlamadan ilerlemeyi gösteriyor.
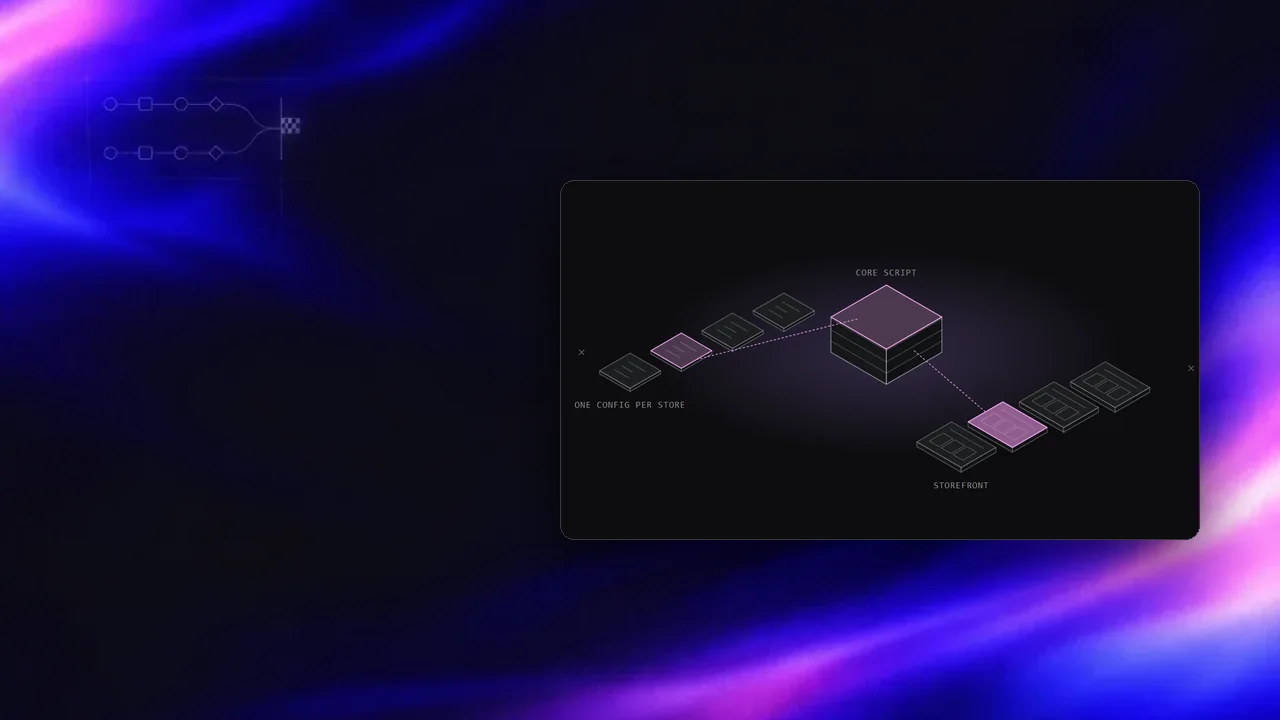
Model sağlayıcıları takılıp çıkarılabiliyor. Gemini, Ollama, Hugging Face ve DeepSeek aynı arayüzün arkasında kayıtlı ve konfigürasyonla açılıyor. Embedding modeli değiştirmek bana sessiz bir hata öğretti: farklı modellerin vektörleri farklı uzunlukta ve onları karşılaştırmak anlamsız skorlar üretiyor. Arama artık embedding boyutu sorgununkiyle eşleşmeyen chunk'ları eliyor.
Farklı yapacaklarım
Doküman Merkezi'nin store'u bellekte. Servisi yeniden başlatırsanız tüm dokümanlar ve embedding'ler gidiyor. Prototip için yeterli, ötesi için yanlış. Sıradaki adım kalıcı bir vektör deposu.
Token sayısı bir tahmin: kelime sayısı çarpı 1,3. Türkçe eklemeli bir dil; uzun Türkçe kelimelerde bu sayının düşük kaldığını düşünüyorum. Gerçek bir tokenizer koyardım.
Deploy (uygulamanın yeni sürümünü sunucuya yükleyip çalışır hale getirme) hattı da fazla akıllıydı. Kodu bir çalışma kopyası, bir build (kaynak kodu çalıştırılabilir veya yayımlanabilir çıktıya dönüştürme) makinesi ve bir sunucu arasında mirror-sync script'iyle (belirli bir işi yapan kod dosyası) aynalıyordum. Ters yönde çalıştırılırsa yeni dosyaları siliyor. Bir review (değişikliğin başka biri tarafından incelenmesi) bunu sorun çıkmadan yakaladı, ama bozuk bir restore script'i 3 kaynak dosyayı JSON (veriyi alan ve değer çiftleriyle taşıyan metin biçimi) olarak kodlanmış string (metin değeri) halinde yazmıştı bile. Bugün tek repo ve tek build adımı kullanırdım.
Son
İki yarı, tek mühendis; zor kısımların çoğu eski sistemin gerçekte ne yaptığını okumaktı.
Diğer Revotas çalışmaları /tr/calismalar/revotas/ adresinde.
Bu yazı İngilizce aslından Türkçeye çevrilmiştir.
Bu yazıya bırakılan notlar
Katıl
Yükleniyor…
Bir yorum bırak.
Bu yazıya not eklemek için giriş yap.
Sadece adın ve avatarın kullanılır.