NVIDIA Nemotron 3 Diarization: hızlı ama kalabalıkta zorlanıyor
Ses kaydında kimin konuştuğunu ayıran modelde gecikmeyi azaltmak az hata ekliyor. Dörtten fazla konuşmacı ise hata oranını yaklaşık üçe katlıyor.
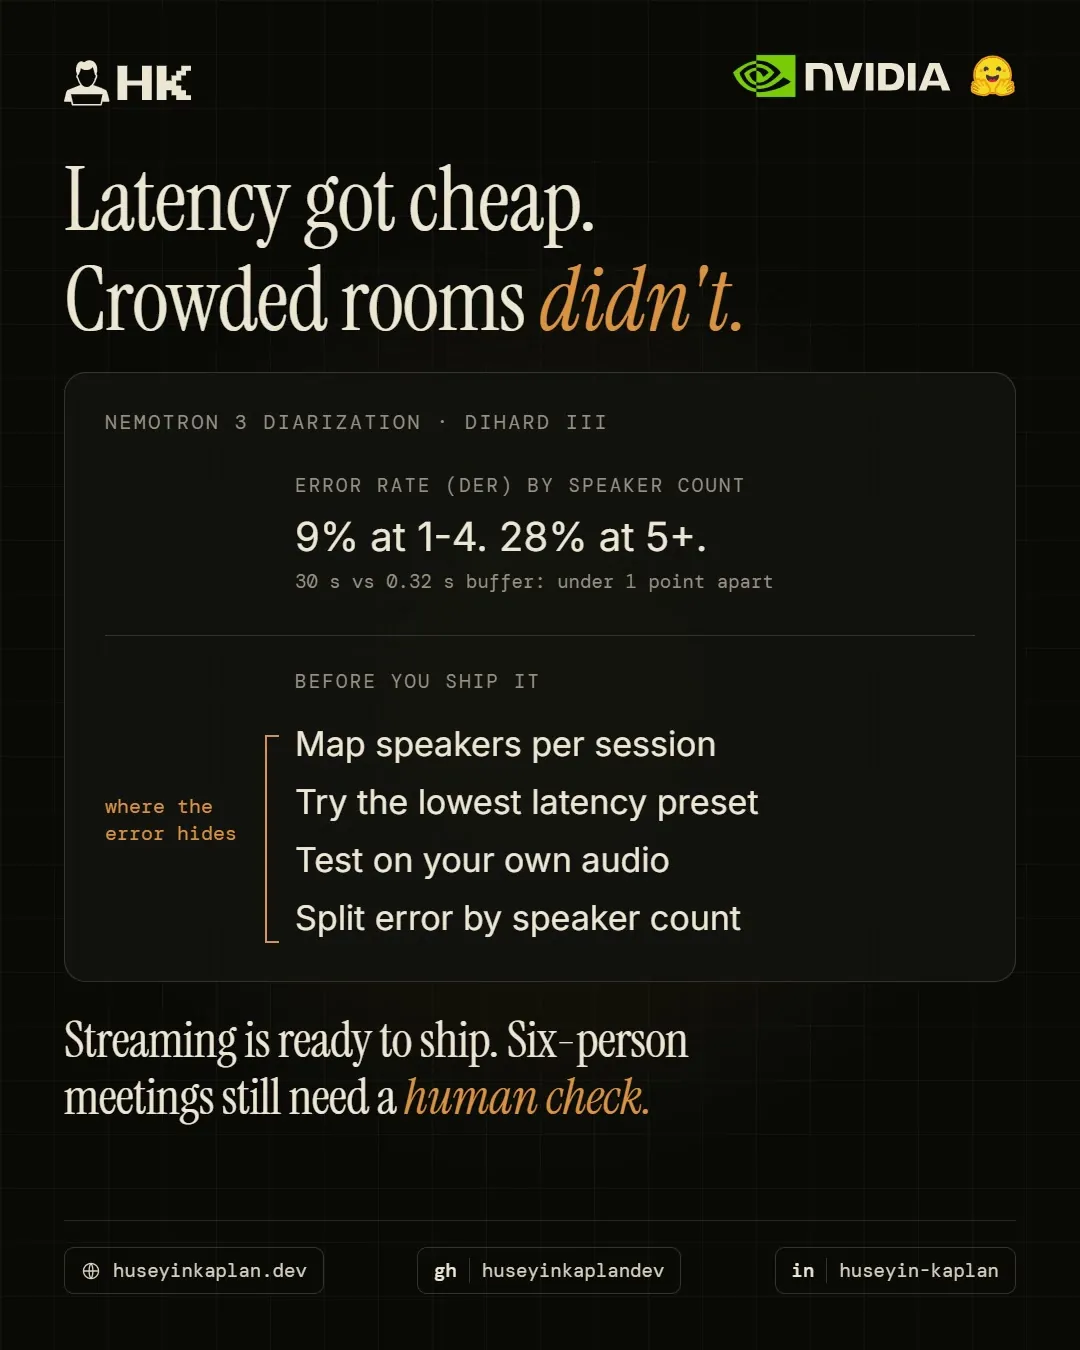
Toplantı kaydını yazıya çevirirken kelimeleri duymak yetmez; hangi cümleyi kimin söylediğini de ayırmak gerekir. Buradaki model, konuşmacı sayısı arttığında zorlanıyor. Her toplantı transkript aracı aynı duvara çarpar: kim ne dedi.
NVIDIA dün Nemotron 3 Diarization'ı (ses kaydında kimin ne zaman konuştuğunu ayırma) Hugging Face'te yayınladı. Açık ağırlıklar (modelin eğitimde öğrendiği sayısal değerlerin paylaşılması), 100M (100 milyon) parametre (modelin eğitimde öğrendiği sayısal değer), sekiz konuşmacıya kadar, ticari kullanıma izin var.
Demo, aynı anda konuşan sekiz sesi gösteriyor. Model kartında ise daha işe yarar bir sayı var.
DIHARD III benchmark'ında (yöntemleri aynı koşullarda karşılaştıran ölçüm) input (girdi) buffer'ı (işlenmeden önce biriktirilen ses bölümü) 30 saniyeden saniyenin üçte birine indirmek bir puandan az hata ekliyor. Dört konuşmacıdan beş veya daha fazlasına çıkmak ise hatayı kabaca üçe katlıyor, yaklaşık %9'dan yaklaşık %28'e.
Bir ürüne bağlamadan önce:
- Konuşmacıları oturum bazında eşleyin. Kanal 0, ilk konuşan kişidir.
- En düşük latency (istekle yanıt arasında geçen gecikme) preset'ini (önceden hazırlanmış ayar veya görünüm şablonu) deneyin. Neredeyse hiç doğruluk kaybettirmiyor.
- Kendi sesinizle test edin. Demo sesleri temiz ve sentetik.
- Hata oranınızı konuşmacı sayısına göre ayırın.
Gecikmeyi azaltmak artık daha az doğruluk kaybettiriyor. Kalabalık konuşmalarda kimin konuştuğunu ayırmak ise hâlâ zor.
Bu yazı İngilizce aslından Türkçeye çevrilmiştir.
Bu yazıya bırakılan notlar
Katıl
Bir yorum bırak.
Bu yazıya not eklemek için giriş yap.
Sadece adın ve avatarın kullanılır.