ldraw-nova: AI agent'lar LEGO modellerini Python koduyla tasarlıyor
ldraw-nova'da modeller ham koordinat yerine bir plan ve Python generator yazıyor; ama fiziği ya da dengeyi hiçbir şey test etmiyor.
Magnitude'un 2 katlık hızı decode'da; 64K context'te agent turu çoğunlukla prefill olduğundan tur yalnızca yaklaşık %12 kısalıyor.
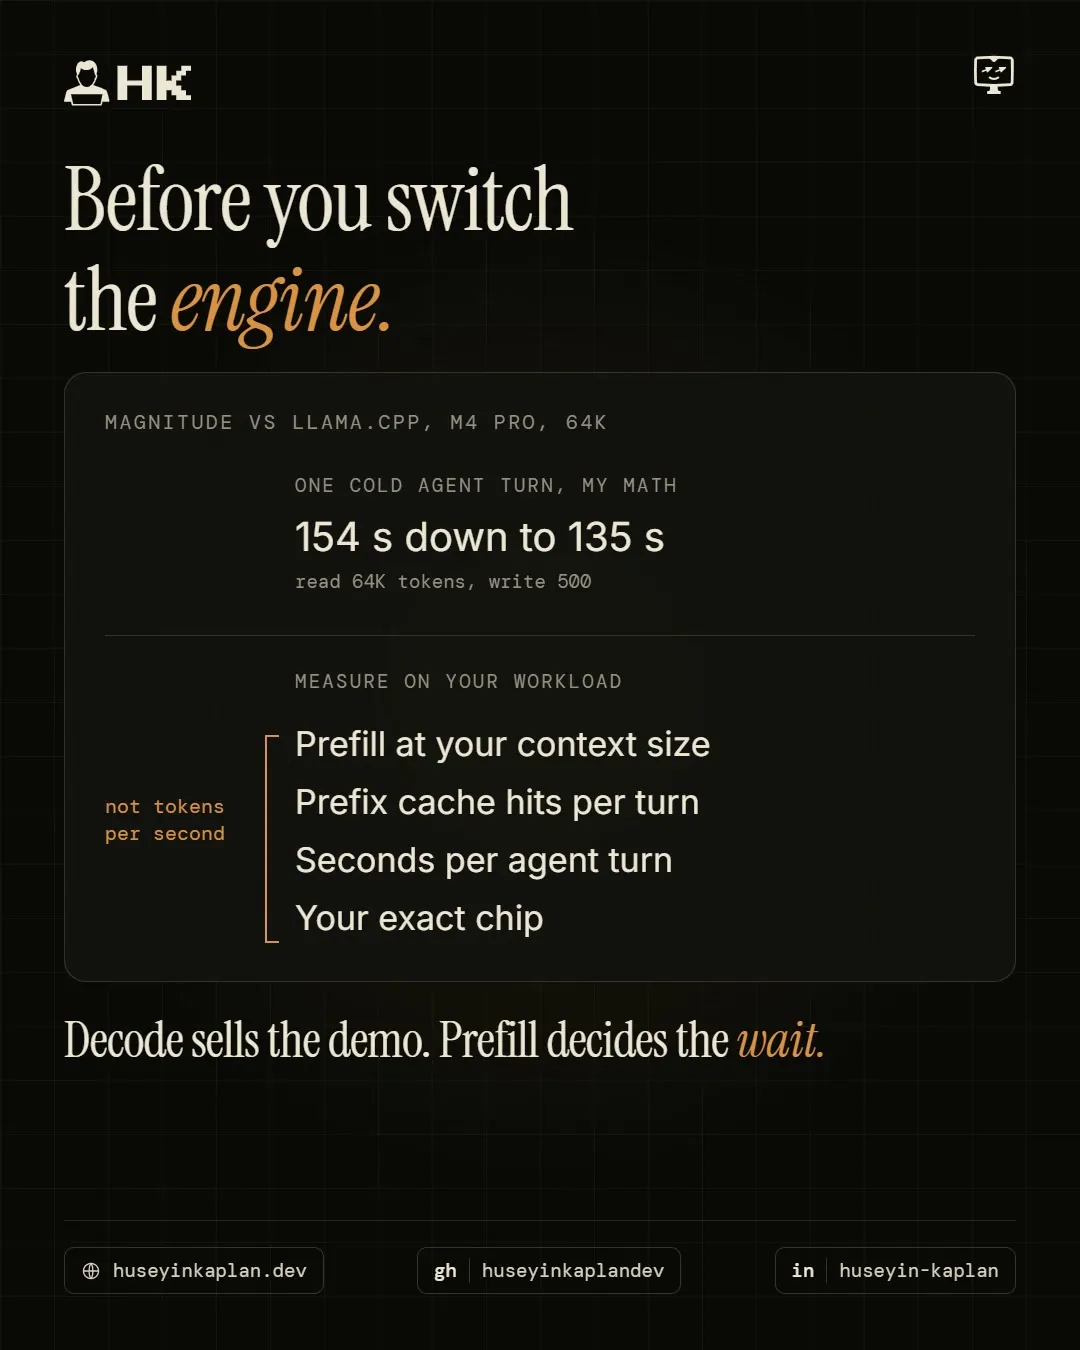
"llama.cpp'den 2 kata kadar daha hızlı", bu hafta Magnitude'un Launch HN paylaşımının başlığıydı. O 2 kat decode'da. Prefill %9 kıpırdadı.
Magnitude, agent'lar için açık kaynak bir yerel inference motoru. GPU kernel'lerini kendi makinenizde ayarlıyor, model başına yaklaşık bir dakikada.
Mac rakamları, 64K context'te Qwen 35B:
Tek bir soğuk agent turu için hesabı yaptım. 64K token'ı okumak iki motorda da iki dakikadan uzun sürüyor. 500 token'lık bir cevabı yazmak 17 saniyeden 9'a iniyor. Tur yarı yarıya değil, yaklaşık %12 kısalıyor.
Bir agent turu çoğunlukla okumadır: tool çıktısı, diff'ler, dosyaların tamamı. Bu da prefill demek.
Motor değiştirmeden önce ölçün:
Demoyu decode satar. Beklemeyi prefill belirler.
Bu yazı İngilizce aslından Türkçeye çevrilmiştir.
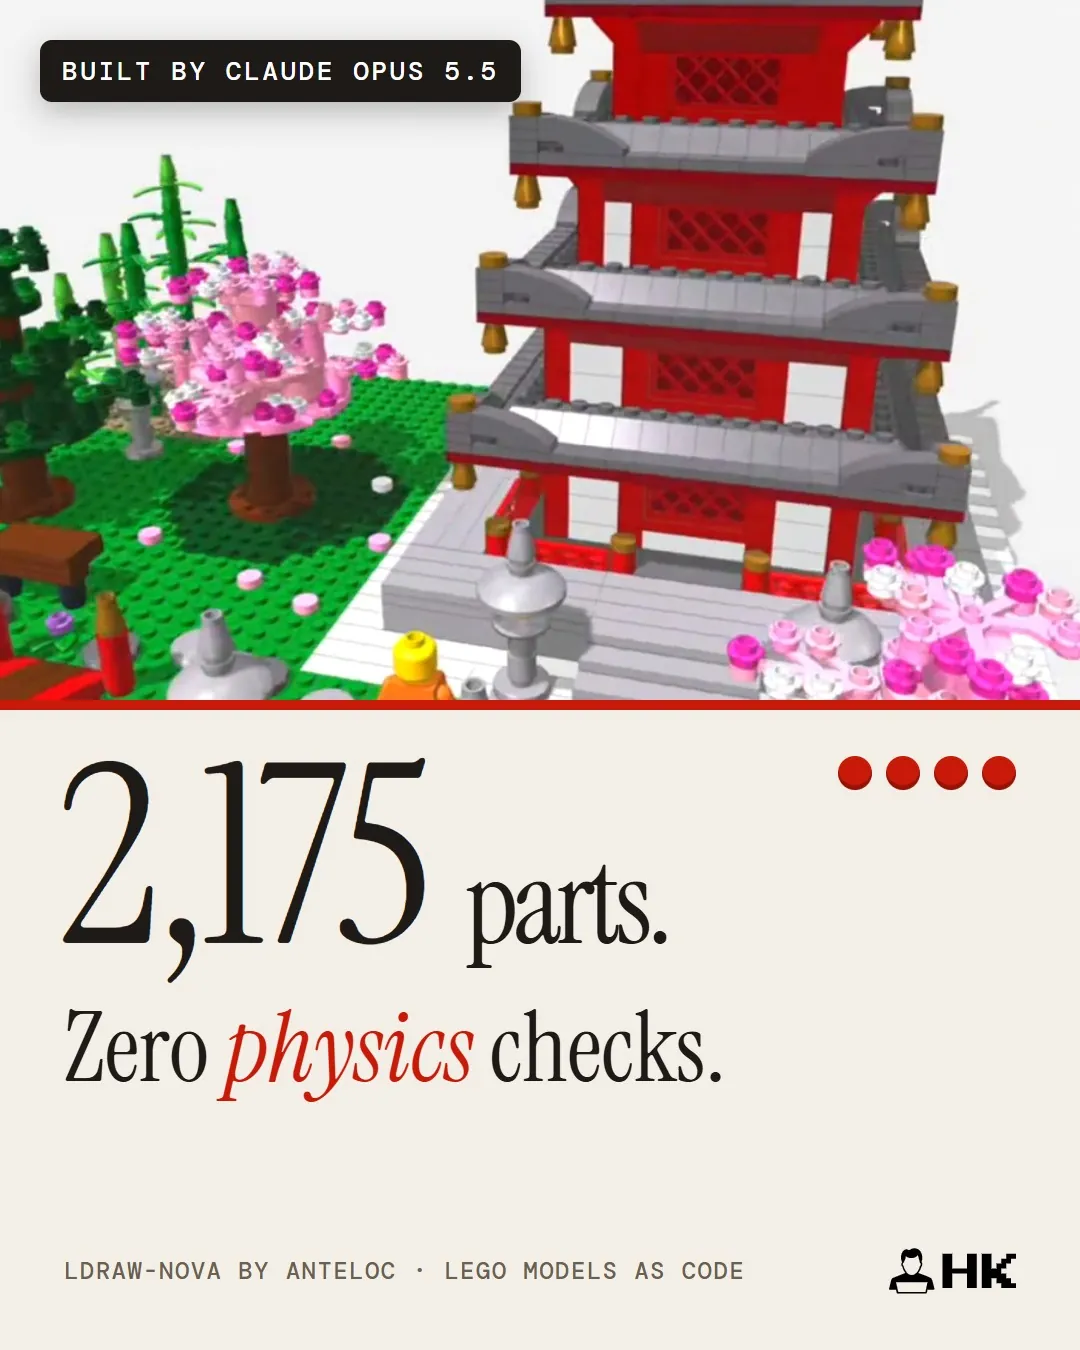
ldraw-nova'da modeller ham koordinat yerine bir plan ve Python generator yazıyor; ama fiziği ya da dengeyi hiçbir şey test etmiyor.
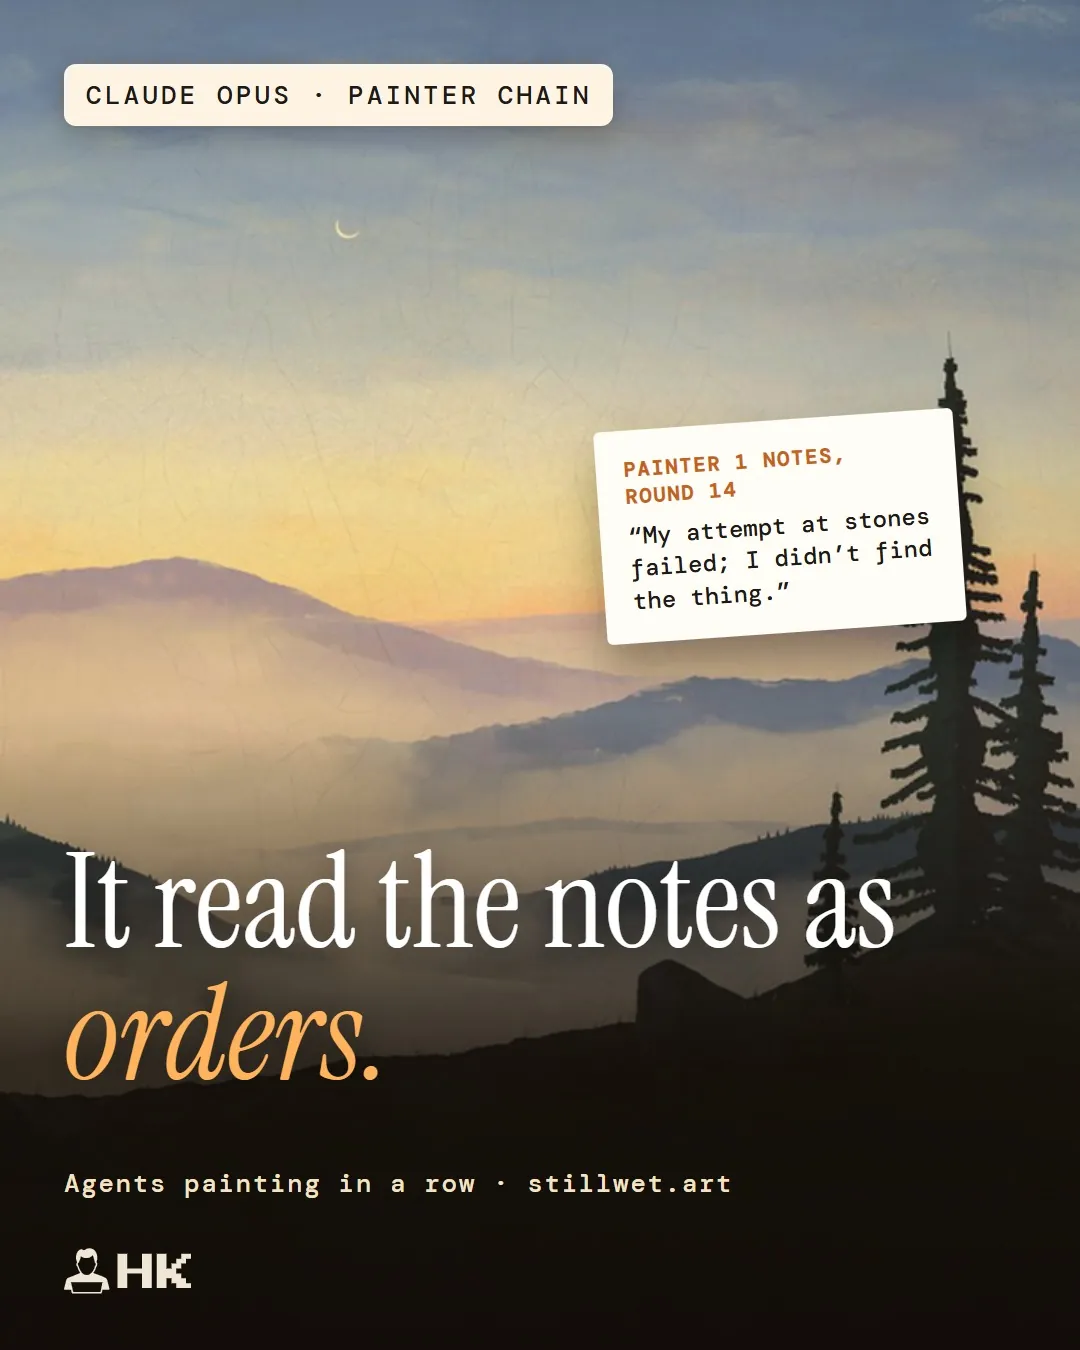
stillwet'in ressam zincirlerinde Claude önceki notları talimat sandı, eksik notlar sessizce kayboldu; agent handoff'larını etiketleyin, loglayın.
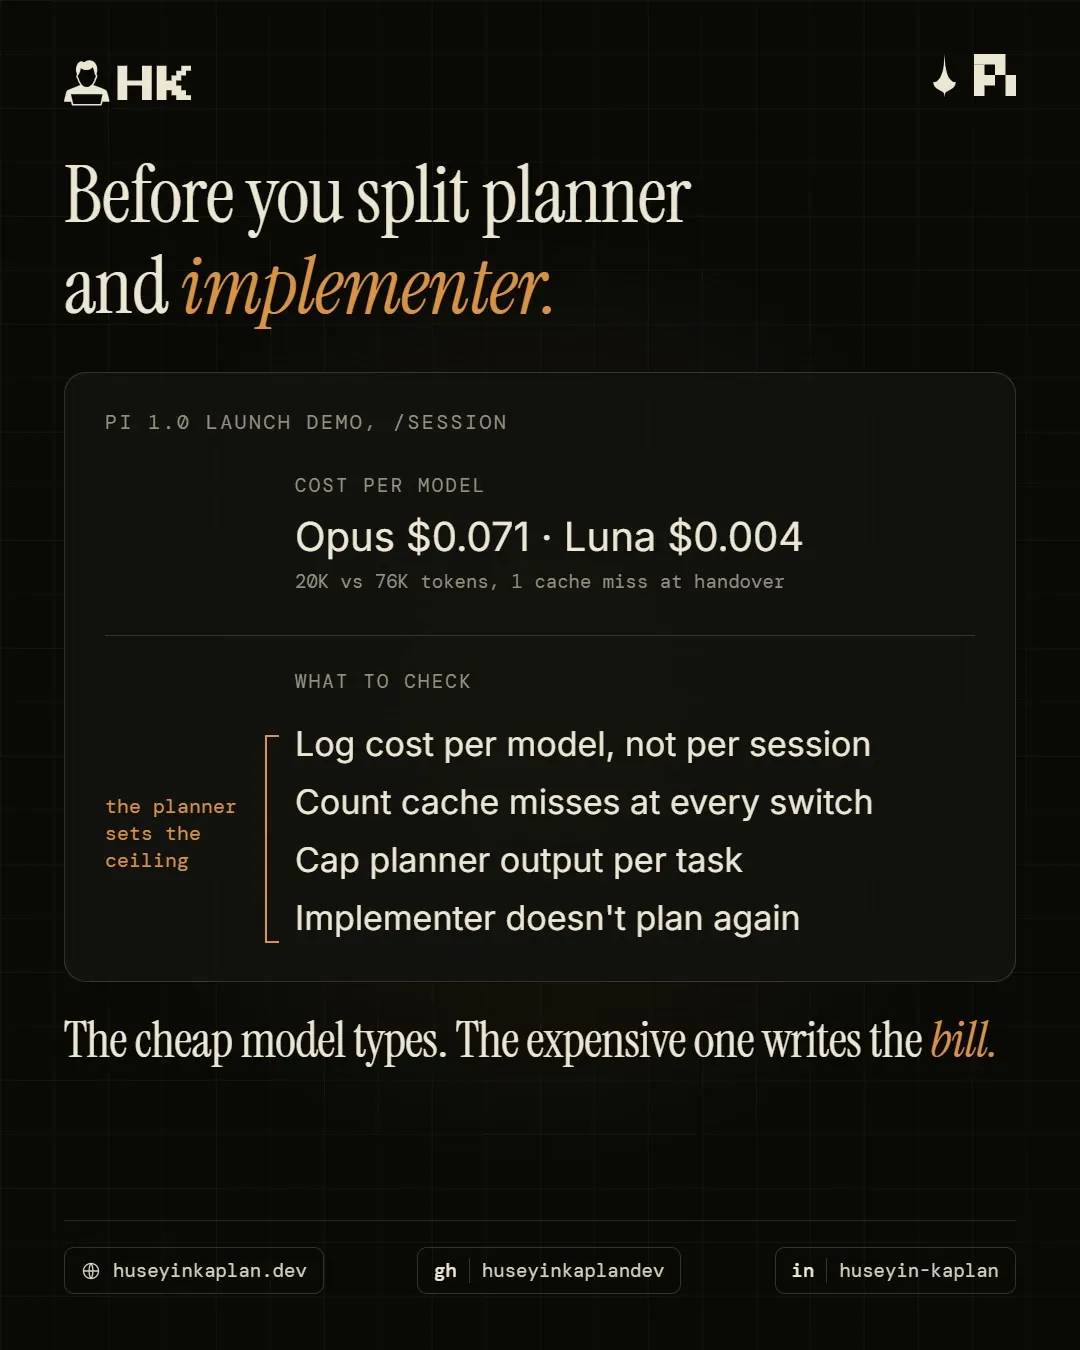
Pi 1.0 demosunda Opus token'ların beşte birini kullanıp GPT 6 Luna'dan 18 kat pahalıya geldi; maliyeti model başına ölçün.